VideoPoet de Google : Un modèle multimodal qui génère de la vidéo et de l'audio
infohightech ·

En bref
VideoPoet est un nouveau modèle multimodal qui accepte le texte, les vidéos, les images et l'audio pour générer, éditer et styliser des vidéos.
Contrairement à d'autres modèles vidéo basés sur la diffusion, VideoPoet combine plusieurs capacités de génération vidéo dans un seul LLM.
Les chercheurs de Google ont dévoilé un grand modèle de langage capable d'accepter des entrées multimodales (texte, images, vidéos et audio) pour générer des vidéos.
Baptisé VideoPoet, il est doté d'une architecture de transformateur de décodeur uniquement, qui est de type "zero-shot", ce qui signifie qu'il peut créer du contenu sur lequel il n'a pas été formé. Il suit un processus de formation en deux étapes similaire à celui des LLM : préformation et adaptation spécifique à la tâche. Le LLM pré-entraîné devient la base qui peut être adaptée à plusieurs tâches de génération vidéo, ont déclaré les chercheurs.
Contrairement aux modèles vidéo concurrents qui sont des modèles de diffusion - ce qui signifie qu'ils ajoutent du bruit aux données d'entraînement et les reconstruisent ensuite - VideoPoet intègre de nombreuses capacités de génération vidéo au sein d'un seul LLM sans avoir de composants entraînés séparément et spécialisés dans leurs tâches.
VideoPoet peut réaliser des générations texte-vidéo, image-vidéo, stylisation vidéo, inpainting et outpainting vidéo et vidéo-audio.

Crédit : Google
VideoPoet est un modèle autorégressif - ce qui signifie qu'il génère des résultats en regardant ce qu'il a généré précédemment - formé à la vidéo, au texte, à l'image et à l'audio en utilisant des tokenizers pour convertir l'entrée vers et à partir de différentes modalités.
"Nos résultats suggèrent le potentiel prometteur des LLM dans le domaine de la génération de vidéos", ont déclaré les chercheurs. En ce qui concerne les orientations futures, notre cadre devrait être en mesure de prendre en charge la génération "any-to-any", c'est-à-dire qu'il devrait être possible de l'étendre au texte-audio, à l'audio-vidéo et au sous-titrage vidéo, parmi beaucoup d'autres.
Voir la démo du site web. VideoPoet n'est pas encore accessible au public.
Ce que VideoPoet peut faire
Du texte à la vidéo
Texte d'incitation : Deux pandas jouent aux cartes
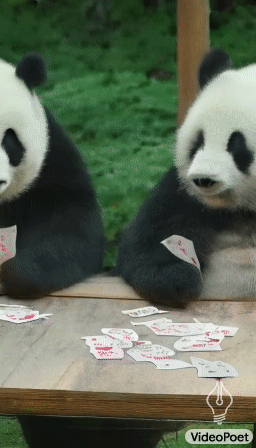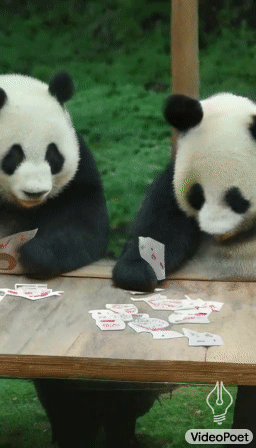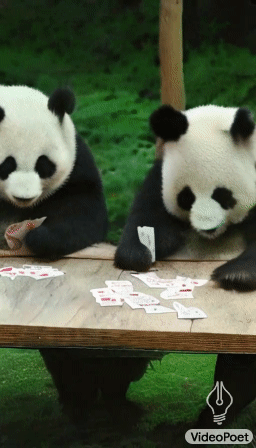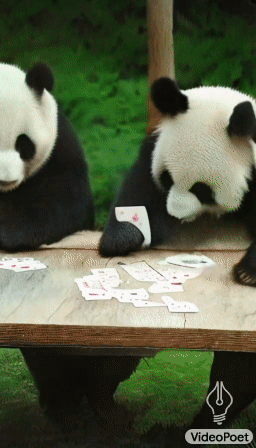
De l'image à la vidéo avec des invites de texte
Texte « prompt » des images (à partir de la gauche) :
1. A ship navigating the rough seas, thunderstorm and lightning, animated oil on canvas
2. Flying through a nebula with many twinkling stars
3. A wanderer on a cliff with a cane looking down at the swirling sea fog below on a windy day
Image (à gauche) et vidéo générée (immédiatement à droite)
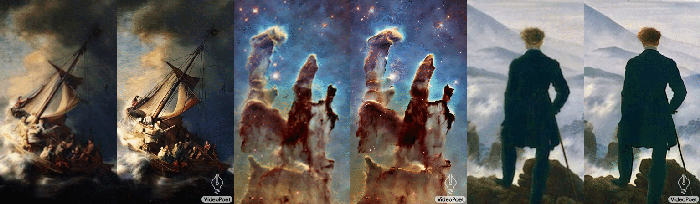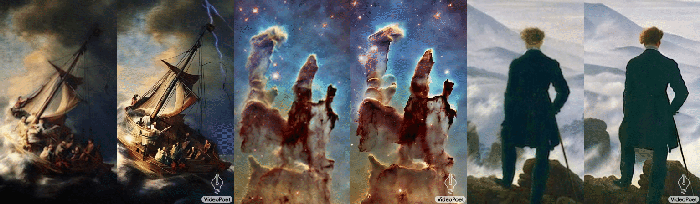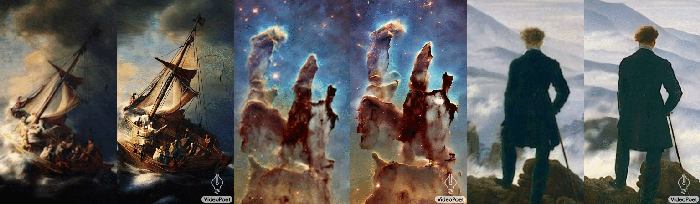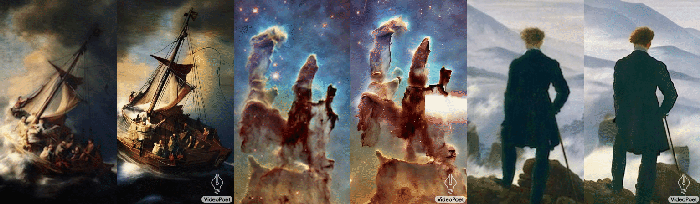
Stylisation d'une vidéo en plan zéro
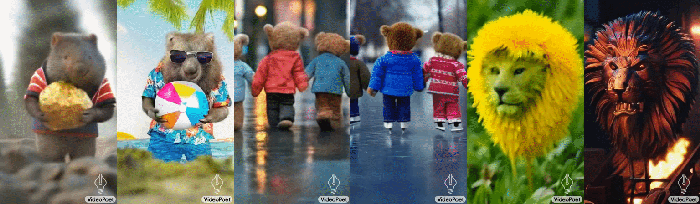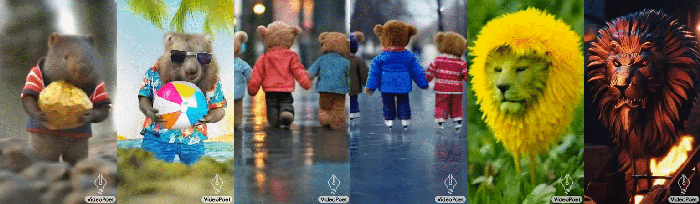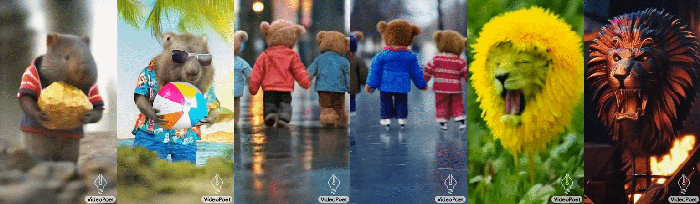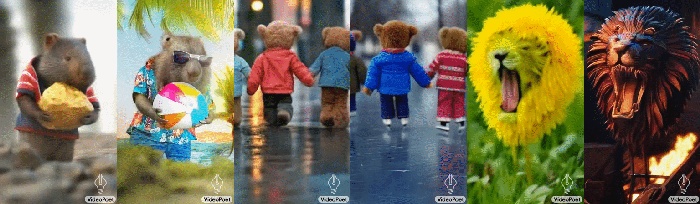
VideoPoet peut également modifier une vidéo existante à l'aide d'invites textuelles.
Dans les exemples ci-dessous, la vidéo de gauche est la vidéo originale et celle qui se trouve juste à côté est la vidéo stylisée. De gauche à droite : Wombat portant des lunettes de soleil et tenant un ballon de plage sur une plage ensoleillée ; ours en peluche patinant sur un lac gelé cristallin ; lion de métal rugissant à la lumière d'une forge.
De la vidéo à l'audio
Les chercheurs ont d'abord généré des clips vidéo de 2 secondes et VideoPoet a prédit le son sans aucune aide textuelle.
VideoPoet peut également créer un court métrage en compilant plusieurs clips courts. Les chercheurs ont d'abord demandé à Bard, le rival de Google pour le ChatGPT, d'écrire un court scénario à l'aide de messages-guides. Ils ont ensuite généré des vidéos à partir de ces invites, puis ont rassemblé le tout pour produire le court-métrage.
Selon Google, VideoPoet peut résoudre le problème de la génération de vidéos plus longues en conditionnant la dernière seconde des vidéos pour prédire la seconde suivante. "En enchaînant ce processus de manière répétée, nous montrons que le modèle peut non seulement allonger la vidéo, mais aussi préserver fidèlement l'apparence de tous les objets, même après plusieurs itérations", écrivent-ils.
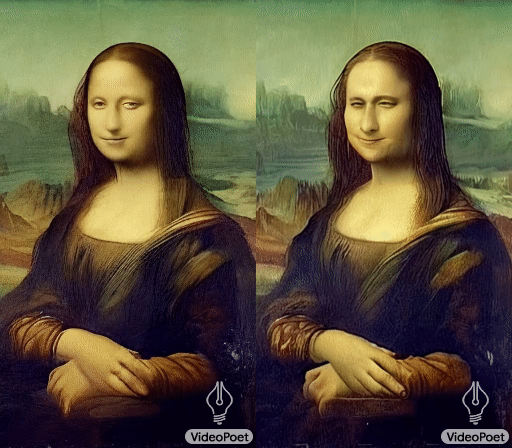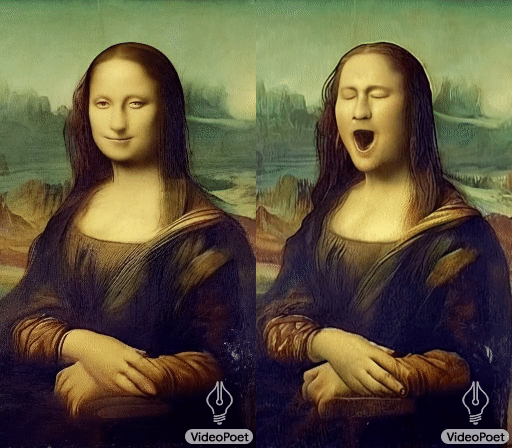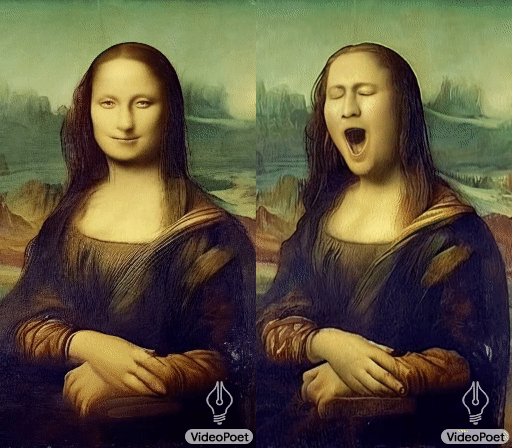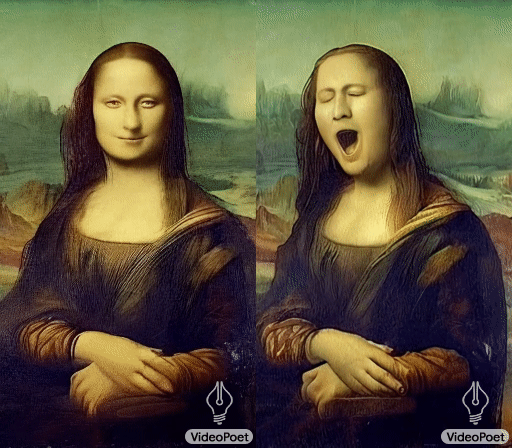
VideoPoet peut également prendre des vidéos existantes et modifier la façon dont les objets s'y déplacent. Par exemple, une vidéo de la Joconde est incitée à bâiller.
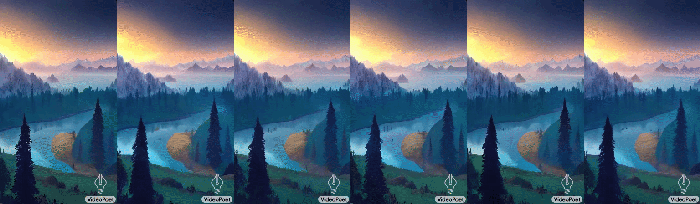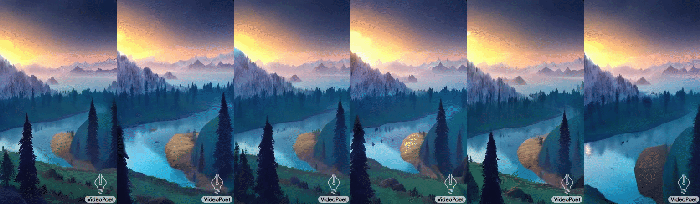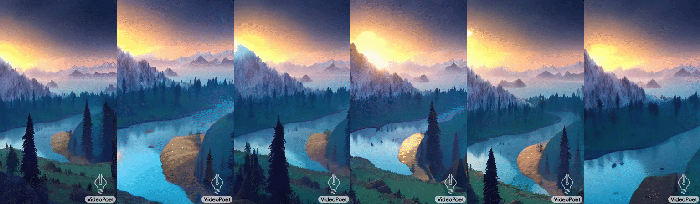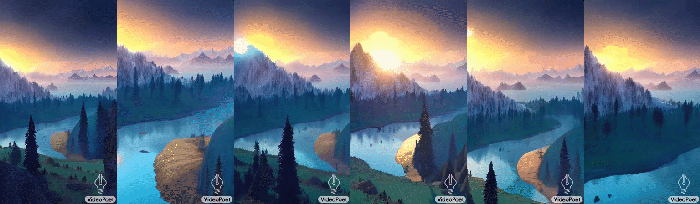
Les invites textuelles peuvent également être utilisées pour modifier les angles de caméra d'images existantes.
Par exemple, cette invite a permis de créer la première image : Image conceptuelle d'un jeu d'aventure représentant un lever de soleil sur une montagne enneigée au bord d'une rivière cristalline.
Les invites suivantes ont ensuite été ajoutées, de gauche à droite : Zoom arrière, Dolly zoom, Panoramique à gauche, Plan en arc, Plan de grue et Plan de drone FPV.
https://aibusiness.com/nlp/google-s-videopoet-a-multimodal-model-that-generates-video-audio