
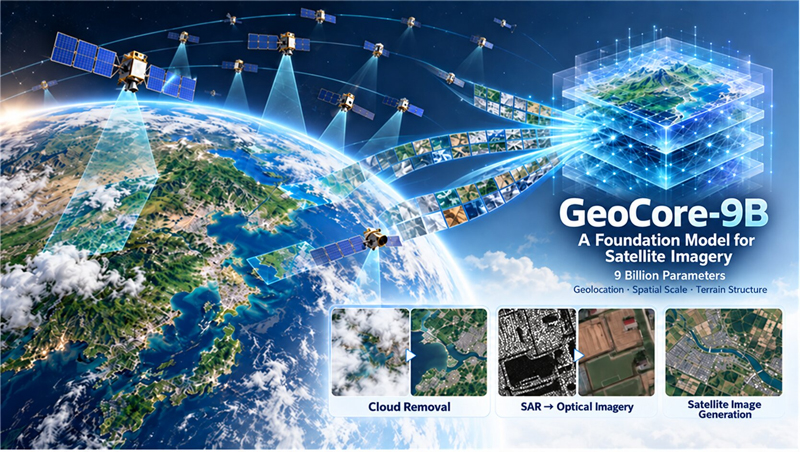
Illustration conceptuelle des applications de recherche de GeoCore-9B. L’image montre comment un modèle de base génératif, entraîné sur des images satellites du monde entier, peut être appliqué à la recherche sur la suppression des nuages, la conversion d’images SAR en images optiques et la génération d’images satellites. Elle ne représente ni un réseau satellite opérationnel, ni un système d’observation de la Terre en temps réel. Crédit : Institut supérieur coréen des sciences et technologies (KAIST)
Les images satellites de la Terre ne sont pas toujours faciles à exploiter. Les nuages peuvent masquer le sol, et les images capturées par certaines méthodes diffèrent des photographies classiques, ce qui complique leur interprétation. Une équipe de recherche du KAIST a développé un modèle d’intelligence artificielle capable d’apprendre l’apparence de divers terrains et villes.
Ce modèle peut restaurer les images couvertes de nuages et convertir les images radar en images ressemblant à des photographies ordinaires. Il applique les connaissances acquises lors de la génération d’images satellites à diverses tâches de traitement d’images, ce qui devrait permettre d’étendre l’utilisation des données satellites dans la gestion des catastrophes et la surveillance environnementale.
L’équipe de recherche dirigée par le professeur Munchurl Kim de l’École de génie électrique a développé GeoCore-9B, un modèle d’intelligence artificielle capable de générer, de restaurer et de convertir des images satellites. Lors de son apprentissage, le composant principal de génération d’images du modèle assimile les caractéristiques des images en ajustant environ 9 milliards de valeurs internes, appelées paramètres.
GeoCore-9B est pré-entraîné sur un grand volume de données satellitaires et peut ensuite être adapté à diverses tâches. C’est pourquoi il est classé comme « modèle de base », un type de modèle d’IA servant de fondement à un large éventail de technologies d’IA. Les résultats de cette recherche sont disponibles sur le serveur de prépublication arXiv .
Formation au-delà des photographies ordinaires
Les images satellitaires sont essentielles pour surveiller l’évolution des forêts et des villes et pour intervenir en cas de catastrophes telles que les inondations et les incendies de forêt. Cependant, les images optiques, qui enregistrent la lumière solaire réfléchie par la surface terrestre, ne permettent pas de visualiser clairement le sol par temps nuageux ou la nuit.
Le radar à synthèse d’ouverture (RSO) observe le sol en émettant des ondes radio et en mesurant les signaux réfléchis. Il peut acquérir des images de la surface terrestre la nuit et par temps nuageux. Toutefois, les images RSO diffèrent des photographies ordinaires par leur luminosité et leurs motifs, ce qui les rend difficiles à interpréter.
Afin d’établir une base commune pour le traitement de ces différents types de données satellitaires, l’équipe de recherche a entraîné le modèle de génération d’images principal à partir de données d’observation de la Terre. Au lieu d’adapter le composant principal d’un modèle conçu pour générer des photographies classiques, l’équipe a entraîné un nouveau modèle sur des vues satellitaires aériennes de reliefs, de forêts, de ports et de villes.

Effet de l’alignement sémantique géospatial. Cette figure compare l’influence de l’entraînement avec des caractéristiques issues d’une IA spécialisée dans l’imagerie satellitaire sur les images générées. Dans les zones agricoles circulaires, les installations industrielles, les parkings et les ronds-points, la rangée inférieure présente des contours plus nets et des aménagements plus cohérents. Crédit : Institut supérieur coréen des sciences et technologies (KAIST)
Lieu d’apprentissage, échelle et structure
Le modèle a été entraîné sur 10 millions de paires d’images satellites du monde entier, accompagnées de descriptions. Par exemple, une image de port était associée à la présence de navires et d’entrepôts. Une image de zone rurale était associée à la présence d’une route traversant des champs. Grâce à cet apprentissage à partir de cette vaste collection d’images décrites, l’IA a appris les caractéristiques de divers types de terrains et de zones urbaines.
L’une des caractéristiques essentielles de cette étude est que l’IA a appris non seulement le contenu d’une image, mais aussi sa localisation géographique et l’étendue de la zone couverte. Sur les images satellites, des objets de formes similaires peuvent être de petits bâtiments ou de grandes installations industrielles, selon leur taille réelle. Il est donc important de prendre en compte à la fois le lieu de prise de vue et l’échelle spatiale de l’image.
L’équipe a entraîné le modèle en utilisant la latitude, la longitude et la résolution spatiale au sol (GSD), ainsi que des phrases descriptives. La latitude et la longitude indiquent une position sur Terre. La GSD indique la taille de la zone au sol représentée par un pixel, la plus petite unité d’une image. Par exemple, avec une GSD de 1 mètre, un pixel représente une surface au sol d’environ 1 mètre sur 1 mètre. Grâce à ces informations, l’IA a appris à générer des images correspondant à un emplacement et une échelle spatiale donnés.

Évolution des images satellites générées en fonction de la résolution spatiale au sol (GSD). Dans ces exemples, la phrase descriptive est restée inchangée tandis que la GSD a varié de 1 mètre à 32 mètres. Pour des images ayant le même nombre de pixels, une GSD plus élevée élargit la zone couverte, passant de la vue d’installations individuelles à une représentation plus globale de l’occupation du sol. Par exemple, une image de 256 pixels de large couvre une largeur au sol d’environ 256 mètres pour une GSD de 1 mètre et d’environ 8,2 kilomètres pour une GSD de 32 mètres. Ces images ont été générées dans des conditions d’échelle spatiale différentes. Elles ne représentent pas un emplacement réel unique avec un zoom avant ou arrière progressif et ne sont pas des images à super-résolution. Crédit : Institut supérieur coréen des sciences et technologies (KAIST)
L’équipe a également appliqué une technique d’entraînement appelée « alignement sémantique géospatial », qui permet au modèle de représenter plus précisément la structure du terrain et des villes. Grâce à cette technique, le modèle génératif apprend en se référant à des caractéristiques extraites par une IA spécialisée dans l’imagerie satellite. Ces caractéristiques servent de référence d’entraînement et aident le modèle à apprendre les éléments structurels d’une image, comme le tracé des routes et l’emplacement des limites des terres agricoles. L’IA spécialisée n’est utilisée que pendant l’entraînement ; elle n’alourdit donc pas les calculs lors de la génération des images par le modèle.
Restauration des nuages et conversion des images radar
Les chercheurs ont ensuite optimisé GeoCore-9B séparément pour la suppression des nuages et la conversion d’images radar. Ils ont utilisé LoRA (Low-Rank Adaptation), une méthode qui conserve le modèle de base et n’entraîne qu’un petit nombre de paramètres supplémentaires. Cette approche réduit la charge de travail liée au réentraînement complet d’un modèle d’IA volumineux pour chaque tâche.
Lors d’évaluations réalisées à partir de jeux de données satellitaires publics, GeoCore-9B a surpassé les modèles existants dédiés à la restauration d’images couvertes de nuages. Il a obtenu de meilleurs résultats sur les indicateurs clés mesurant la luminosité, la couleur et la similarité structurelle avec les images de référence. Pour la conversion d’images radar en images optiques, il a également atteint les meilleurs résultats sur certains indicateurs évaluant la qualité et la finesse des détails des images générées.
Ces résultats démontrent que les connaissances acquises grâce à la génération d’images satellitaires peuvent également être appliquées à la restauration et à la conversion d’images d’observation réelles. Le modèle devrait permettre une meilleure utilisation des données dont la valeur était limitée par la couverture nuageuse ou les méthodes d’imagerie.
Il devrait également faciliter l’évaluation des conditions dans les zones sinistrées et le suivi de l’évolution des forêts, des terres agricoles et des villes. De plus, l’adaptation d’un modèle unique à de multiples tâches peut réduire les coûts et les délais nécessaires au développement d’une IA distincte pour chaque tâche.

Comparaison d’images satellites générées à partir des mêmes descriptions textuelles. Dans chaque série, les résultats de CRS-Diff, Text2Earth et GeoCore-9B sont présentés de gauche à droite. Crédit : Institut supérieur coréen des sciences et technologies (KAIST)
Tests effectués sur différents capteurs et régions
L’équipe prévoit de valider les performances du modèle sur un plus large éventail de capteurs et de régions. Afin d’appliquer le modèle à la gestion des catastrophes réelles, elle envisage également d’étendre ses recherches pour prédire avec précision les changements sur le terrain, tels que les inondations, les dommages aux bâtiments, les feux de forêt et l’expansion urbaine. L’équipe explorera également des applications dans le domaine de la défense, notamment la surveillance et la reconnaissance.
« En entraînant l’IA sur la localisation de chaque image satellite et sur la taille réelle du terrain qu’elle représente, nous avons rendu possible l’utilisation d’un modèle unique pour de multiples tâches, telles que la suppression des nuages et la conversion d’images », a déclaré Kim. Il a ajouté que ces travaux devraient permettre une utilisation plus large des données satellitaires, limitées par les conditions météorologiques ou les méthodes d’imagerie, ce qui facilitera l’évaluation des situations de catastrophe et le suivi de l’évolution des forêts et des villes.
https://news.kaist.ac.kr/newsen/html/news/?mode=V&mng_no=68390


