
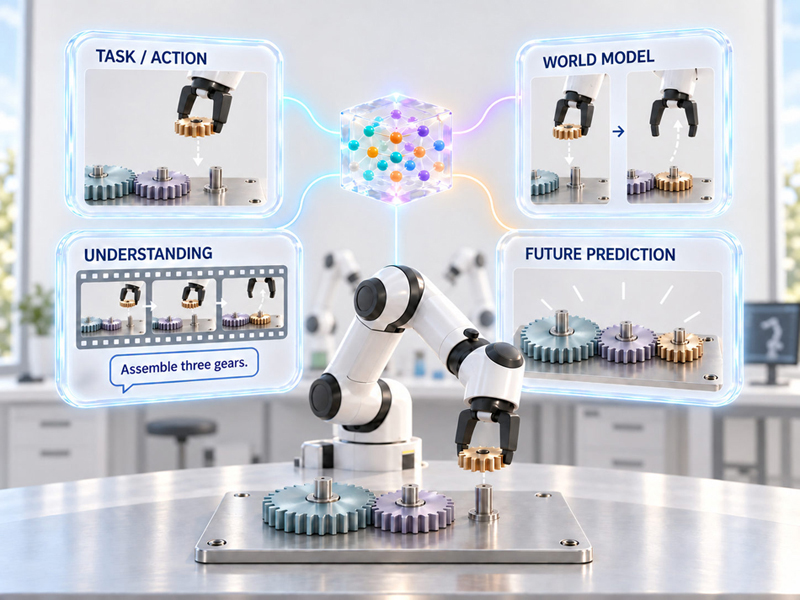
Un système d’intelligence artificielle (IA) robotique a été développé. Il est capable de comprendre les instructions humaines, de prédire l’aspect d’une scène après une action et d’exécuter la tâche. Plutôt que de se contenter de traduire les instructions en mouvements physiques, cette technologie utilise également les résultats anticipés de ces actions pour contrôler le robot.
Une équipe de recherche dirigée par le professeur Jaeyoung Do du laboratoire AIDAS du département de génie électrique et informatique de l’École d’ingénieurs de l’Université nationale de Séoul a développé « Dynin-Robotics », un modèle de base pour la robotique qui gère simultanément le langage, les images, la vidéo et les actions du robot au sein d’un seul modèle. Un modèle de base est un modèle d’IA généraliste entraîné sur divers types de données afin de pouvoir être appliqué à un large éventail de tâches. L’article est disponible sur le serveur de prépublication arXiv .

Dynin-Robotics génère des mouvements robotiques à partir d’instructions humaines et d’images de caméra. Il peut également prédire, sous forme d’image, l’aspect de la scène suivante après une action donnée ou l’aspect final de la scène cible une fois une tâche terminée, et utiliser ces prédictions pour générer et sélectionner des actions. Lors d’évaluations menées dans quatre contextes réels de manipulation robotique, Dynin-Robotics a atteint un taux de réussite moyen de 78,4 %, surpassant ainsi les modèles de comparaison de NVIDIA et de la société américaine d’IA robotique Physical Intelligence utilisés dans les expériences.
L’article décrivant la recherche a été accepté à NeurIPS 2026, l’une des principales conférences internationales mondiales sur l’intelligence artificielle et l’apprentissage automatique, et sa présentation est prévue en décembre.

Présentation du modèle « Dynin-Robotics », qui traite simultanément le langage, les images, la vidéo et les actions du robot au sein d’une architecture unifiée. Crédit : Faculté d’ingénierie de l’Université nationale de Séoul
Rassembler les instructions et les prédictions
Le matériel robotique progresse rapidement, mais la compréhension de nouvelles instructions et l’exécution de tâches dans des environnements inconnus demeurent un défi majeur. Contrairement à la répétition de mouvements appris dans des conditions prédéterminées, les tâches du monde réel impliquent des objets dont la position et la forme varient d’une situation à l’autre, ainsi que des demandes diverses de la part des utilisateurs. Par exemple, pour exécuter l’instruction « Dépose la tasse sur le bureau dans le tiroir et ferme-le », un robot doit identifier l’emplacement de la tasse et du tiroir, puis déterminer une séquence d’actions comprenant le déplacement de la tasse et la fermeture du tiroir.
Des recherches récentes ont exploré l’utilisation des capacités de compréhension du langage de grands modèles de langage tels que ChatGPT pour le contrôle de robots, ainsi que l’utilisation de modèles de génération vidéo pour prédire des scènes futures. Afin d’exploiter à la fois la capacité à comprendre les instructions humaines et celle à prédire les conséquences des actions pour générer les mouvements du robot, l’équipe de recherche a intégré ces capacités dans un modèle unique.
Cette nouvelle technologie étend « Dynin-Omni », un modèle d’IA omnimodale précédemment développé par l’équipe de recherche, au contrôle des robots. L’IA omnimodale désigne une intelligence artificielle capable de comprendre et de générer de multiples formes d’information (langage, images, vidéo et audio) au sein d’un seul modèle. En intégrant des données relatives aux actions du robot à ce cadre, les chercheurs ont conçu un modèle d’IA physique capable d’effectuer des tâches concrètes telles que le déplacement et l’empilement d’objets.
L’une des caractéristiques essentielles de Dynin-Robotics est sa capacité à apprendre conjointement à comprendre les instructions et les scènes, à prédire les conséquences des actions et à générer des mouvements physiques. Le modèle peut également décrire par phrases les actions effectuées par un robot à partir d’un enregistrement vidéo de la tâche.

Résultats montrant la prédiction de la scène suivante en fonction de la scène actuelle et de l’action du robot (en haut), la génération de la scène cible après l’exécution de la tâche selon une instruction de l’utilisateur (au milieu) et une description textuelle de la tâche effectuée à partir de la vidéo de celle-ci (en bas). Crédit : Faculté d’ingénierie de l’Université nationale de Séoul
Comprendre le sens et anticiper les résultats
Les chercheurs ont démontré les avantages de cette approche d’apprentissage unifiée à travers des simulations de cueillette de fruits et de composition florale. Un modèle entraîné conjointement à la compréhension, à la prédiction et à la génération d’actions s’est avéré plus performant pour exécuter des instructions formulées de manière inhabituelle qu’un modèle entraîné uniquement à la génération d’actions. Il a répondu non seulement aux instructions spécifiant directement un objet, telles que « Mets la rose », mais aussi à celles qui le désignaient indirectement par le sens, comme « Mets la fleur qui symbolise l’amour ».
La prédiction de la scène future aide le robot à décider de l’action à entreprendre. De la même manière qu’une personne peut visualiser l’emplacement d’un objet et son aspect final avant de le déplacer, le robot peut générer une image de la scène attendue après l’exécution d’une tâche, en se basant sur la scène actuelle et les instructions reçues. L’équipe de recherche a mis en œuvre des méthodes qui utilisent la scène cible prédite soit comme référence pour générer des actions, soit pour évaluer les actions possibles et sélectionner la plus appropriée.
Des actions plus rapides et des résultats concrets
Les chercheurs ont également réduit le temps de calcul nécessaire à la génération d’actions. Ils ont appliqué une approche qui regroupe les informations nécessaires à une séquence d’actions et les prédit en parallèle. Les informations utilisées à plusieurs reprises lors du calcul sont également réutilisées pour améliorer l’efficacité de la génération de la prochaine action du robot. La vitesse de génération d’actions interne du modèle a été améliorée jusqu’à environ 29,2 fois par rapport à la version non optimisée et jusqu’à environ 36,6 fois plus rapide que le modèle « π0,5 » de Physical Intelligence.
Lors d’expériences robotiques en conditions réelles, l’équipe a évalué quatre scénarios de manipulation : le déplacement de fruits, le tri de blocs par couleur, l’empilement de blocs sans ordre imposé et l’empilement de blocs selon une séquence de couleurs spécifique. En moyenne, sur ces quatre scénarios, « GR00T N1.6 » de NVIDIA a obtenu un taux de réussite de 73,0 %, « Cosmos Policy » de NVIDIA de 73,6 % et « π0.5 » de Physical Intelligence de 76,9 %. Dynin-Robotics a enregistré 78,4 %, soit le taux de réussite moyen le plus élevé parmi les modèles comparés lors de l’évaluation.
Le déploiement industriel nécessite des essais plus approfondis
Cette technologie pourrait être appliquée à des tâches exigeant des robots qu’ils prennent en compte à la fois les instructions humaines et leur environnement, comme le tri et le transport d’objets dans les opérations logistiques ou la manipulation de composants dans les processus de fabrication. Cependant, les résultats actuels ont été validés par des simulations et dans des environnements expérimentaux robotiques réels prédéterminés. Avant son déploiement en milieu industriel, ses performances devront être évaluées sur une plus grande variété d’objets, de tâches et d’environnements opérationnels.
S’appuyant sur la série de modèles de base Dynin, l’équipe de recherche prévoit d’évaluer son applicabilité à la manutention de composants, à l’assemblage, au tri d’objets et à d’autres tâches dans les environnements de production et de logistique. L’équipe envisage également de développer des modèles spécifiques à chaque domaine grâce à des formations complémentaires adaptées aux données et aux exigences des secteurs de la production et de la médecine.
Vers des robots qui apprennent de l’expérience
À cette fin, les chercheurs développent des technologies permettant une manipulation précise grâce à des mains robotisées, la reconnaissance des états de contact par des capteurs tactiles et de force , et une adaptation rapide à de nouvelles tâches et environnements. Ils mènent également des recherches conjointes avec des chercheurs de la faculté de médecine de l’université nationale de Séoul sur l’application de l’IA aux robots d’assistance chirurgicale et aux robots endoscopiques gastro-intestinaux.
L’équipe mène également des recherches sur des agents d’IA capables de décomposer un objectif défini par un humain en plusieurs tâches, de les assigner à des robots, d’évaluer les résultats et d’adapter les actions suivantes en conséquence. Par exemple, face à une requête telle que « Débarrasser la table », un agent d’IA pourrait décomposer cette requête en tâches nécessaires, les transmettre au robot, évaluer les résultats et permettre au robot de réessayer les tâches ayant échoué en utilisant une approche différente.
En s’appuyant sur l’expérience accumulée des tentatives réussies et infructueuses, les chercheurs prévoient de développer ce qu’ils décrivent comme un « robot qui devient plus intelligent à mesure qu’il est utilisé », améliorant continuellement ses capacités de planification et d’exécution des tâches.
Jaeyoung Do, qui a supervisé la recherche, a déclaré : « Cette étude est importante car un modèle unique gère simultanément ce qu’un robot doit faire, comment son environnement évoluera après son déplacement et quelles actions il devra entreprendre. » Il a ajouté : « Forts de cette avancée, qui étend la technologie d’IA unifiée de Dynin-Omni au contrôle des robots, nous poursuivrons le développement d’une intelligence robotique capable de dépasser le cadre expérimental pour comprendre les instructions humaines et réaliser des tâches complexes en conditions réelles. »
https://www.snu.ac.kr/research/highlights?md=v&bbsidx=177380


